Il existe une analyse que tout responsable informatique, juriste d’entreprise et responsable conformité devrait connaître. C’est celle que Duff Johnson, de la PDF Association, a consacrée au rapport Mueller : d’abord dans un article technique, puis dans une intervention à l’Electronic Document Conference 2019 au titre éloquent, « The Mueller Report PDF: a content management #fail for the history books ».
Johnson y raconte le désastre technique derrière la publication de l’un des documents judiciaires les plus importants de l’histoire américaine récente. C’est un cas d’école de ce qu’il ne faut pas faire quand confidentialité et accessibilité entrent en tension.
Mais ce n’est pas un problème uniquement américain. Deux ans plus tard, la Commission européenne a commis une erreur tout aussi spectaculaire : différente dans la technique, identique sur le fond.
Voici les trois actes d’une comédie des erreurs numériques, qui montre pourquoi le « rectangle noir » ne suffit pas.
Acte un : l’erreur « Manafort » (le texte sous le noir)
Janvier 2019. Les avocats de Paul Manafort, ancien directeur de campagne de Trump et figure clé de l’enquête du procureur spécial Robert Mueller, déposent un mémoire devant le tribunal fédéral.
Le PDF contient des passages sous scellés sur les relations entre Manafort et Konstantin Kilimnik, un homme qui, selon le FBI, a des liens avec le renseignement russe. Les avocats les ont recouverts de rectangles noirs.
Un seul problème : le texte en dessous était toujours là.
Des journalistes ont sélectionné les lignes « caviardées », les ont copiées et collées dans un document Word, comme l’a raconté VICE News. Des informations sous scellés, lisibles en quelques secondes : entre autres, l’accusation d’avoir partagé avec Kilimnik des sondages de la campagne de 2016.
L’erreur technique ? Les rectangles noirs étaient simplement dessinés par-dessus le texte. Un véritable outil de caviardage supprime le contenu du fichier ; ici, le texte d’origine était resté intact, sous la peinture.
Leçon n° 1 : recouvrir n’est pas caviarder. C’est une illusion d’optique.
Acte deux : la réaction « Mueller » (le gâchis)
Avril 2019. Trois mois après l’embarras Manafort, le ministère de la Justice (DOJ) publie le rapport Mueller : 448 pages, fruit d’une enquête qui a coûté aux contribuables près de 32 millions de dollars.
Cette fois, aucun texte ne reste caché sous le noir. Mais le prix est très élevé : le fichier publié est un PDF composé uniquement d’images. Selon la PDF Association, tout indique que le rapport, une fois caviardé, a été imprimé puis passé dans un scanner.
Résultat : un PDF de 139 mégaoctets fait de photos de pages. L’analyse de la PDF Association décrit un échec sur toute la ligne :
- Aucune recherche de texte : pour trouver un nom ou une date, il fallait parcourir 448 pages à la main.
- Accessibilité nulle : pour les lecteurs d’écran utilisés par les personnes aveugles, le document n’était qu’une suite d’images sans texte. Pour l’association, le fichier ne respectait pas la Section 508, la règle fédérale sur l’accessibilité des documents publics.
- Qualité dégradée : des pages granuleuses et une fine ligne jaune laissée par le scanner.
- Poids inutile : un fichier bien plus lourd que ne l’aurait été un PDF natif.
Pour Duff Johnson, le PDF en images était, de toutes les options possibles, « la moins facile à utiliser ». Quelques jours plus tard, le DOJ a republié le rapport avec un texte sélectionnable, mais les problèmes de reconnaissance du texte sont restés.
Leçon n° 2 : ils ont obtenu la confidentialité en détruisant tout le reste.
Acte trois : le « Manafort européen » (les signets oubliés)
Janvier 2021. En pleine pandémie, la Commission européenne est sous pression pour rendre publics ses contrats d’achat de vaccins contre le COVID-19. Le 29 janvier, elle publie le contrat conclu avec AstraZeneca, dont de nombreuses parties sont caviardées pour protéger des informations commerciales confidentielles.
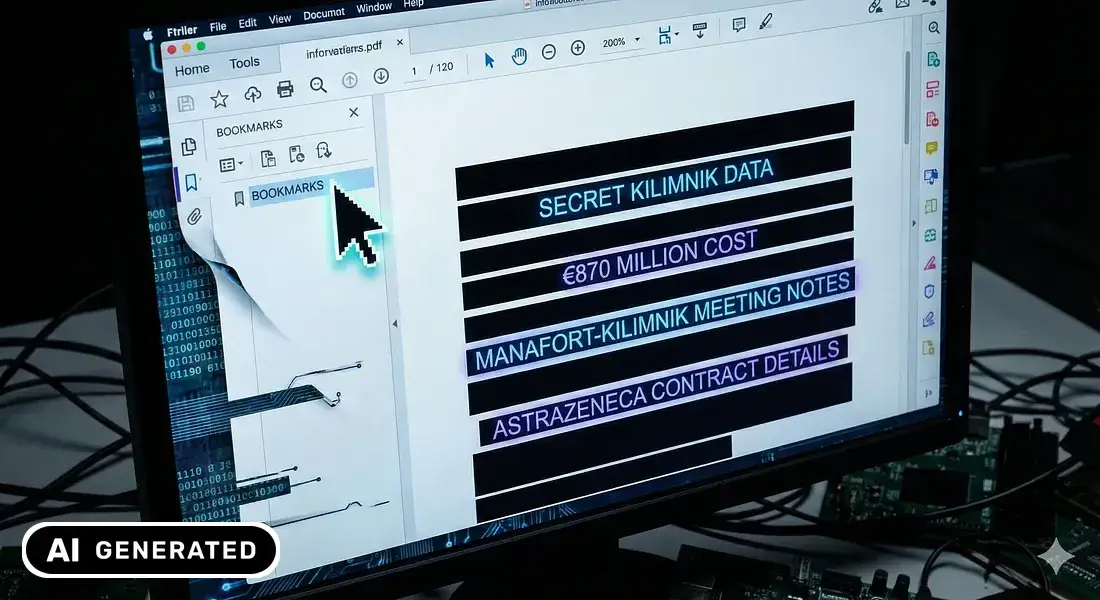
Les barres noires sur le texte étaient toutes en place. Mais personne n’avait vérifié les signets.
Dans les lecteurs PDF, les signets sont l’index de navigation du panneau latéral, souvent généré automatiquement à partir du texte du document.
Ce qui s’est passé :
- Le document affichait des barres noires sur des paragraphes entiers.
- En ouvrant le panneau « Signets », des parties du texte caviardé apparaissaient pourtant en clair.
- Parmi les détails lisibles figuraient des chiffres comme les 870 millions d’euros de coûts prévus pour les doses destinées à l’Union.
Ce sont des internautes et des journalistes du Spiegel qui l’ont remarqué ; The Register l’a raconté le jour même. La Commission a remplacé le PDF dans la journée et a reconnu l’erreur quelques jours plus tard. Mais le mal était fait.
Leçon n° 3 : si vous ne nettoyez pas les couches cachées (métadonnées, signets, structure), vos secrets sont à un clic.
Trois erreurs, une racine commune
La différence technique entre les cas est subtile mais importante :
| Cas | Erreur | Conséquence |
|---|---|---|
| Manafort | Rectangles noirs dessinés par-dessus le texte | Texte copiable avec Ctrl+C |
| AstraZeneca | Signets non nettoyés | Texte confidentiel lisible dans le panneau latéral |
| Mueller | PDF en images (impression et numérisation) | Document lourd, sans recherche et inaccessible |
La racine est la même : traiter le PDF comme une feuille de papier.
Un PDF n’est pas une photographie. C’est un conteneur en couches (comme des lasagnes) qui comprend :
- du texte sélectionnable (le contenu) ;
- des formes et des annotations (ce qui est ajouté par-dessus) ;
- des métadonnées et des signets (informations et navigation) ;
- des balises d’accessibilité (la structure).
Caviarder vraiment un PDF, c’est nettoyer avec précision toutes ces couches.
Pourquoi cela nous concerne (surtout en Europe)
En Europe, on ne peut pas choisir entre vie privée et accessibilité : avec le RGPD d’un côté et les règles d’accessibilité de l’autre, il faut les deux.
Pour les administrations publiques, l’obligation existe depuis des années : la directive (UE) 2016/2102 sur l’accessibilité des sites web et des applications mobiles des organismes du secteur public, transposée dans le droit national de chaque État membre, couvre aussi les documents publiés en ligne. Depuis le 28 juin 2025, l’European Accessibility Act (directive (UE) 2019/882) étend des exigences d’accessibilité à de nombreux produits et services du secteur privé, des services bancaires au commerce en ligne. Un document en images comme le premier rapport Mueller passerait difficilement l’examen.
Et pourtant, la « numérisation défensive » reste courante dans les bureaux : on imprime, on barre au feutre, on scanne. Le résultat est un fichier inutilisable pour les personnes qui ont recours aux technologies d’assistance.
Checklist : que faire en pratique
Si vous gérez des documents juridiques ou RH, voici les règles d’or :
- Utilisez un véritable outil de caviardage. Il doit supprimer le texte, pas le recouvrir. Avec PDF Editor d’Edito, gratuit avec un compte gratuit, le caviardage des données personnelles se fait sur votre ordinateur et il est irréversible. Jamais de formes ni de surligneurs noirs.
- Appliquez et vérifiez. Après le caviardage, essayez de sélectionner la zone et de rechercher dans le fichier un mot que vous avez supprimé. Si vous le trouvez, quelque chose ne va pas.
- Nettoyez les métadonnées. Retirez l’auteur, les commentaires, l’historique des révisions et les pièces jointes qui ne doivent pas sortir avec le document.
- Attention aux signets. Ouvrez toujours le panneau latéral avant de publier : les entrées de l’index peuvent révéler ce que vous avez supprimé dans le texte.
- Ne scannez pas (presque jamais). La numérisation détruit la recherche et l’accessibilité. Si vous n’avez pas d’autre choix, il faut ensuite l’OCR et les balises d’accessibilité : Edito in cloud propose l’OCR avancé, la conversion en PDF/A et la vérification de conformité PDF/A et PDF/UA.
La morale
Le PDF sait faire énormément de choses : c’est sa force, et c’est aussi l’origine de ces désastres. La technologie ne pardonne pas les raccourcis, mais elle offre toujours une solution. À condition que ce ne soit pas le scanner.
Caviardez vos PDF sans qu’ils quittent votre ordinateur.
Télécharger PDF Editor gratuitementIl suffit d’un compte gratuit.
Vous gérez de grands volumes de documents dans une administration, une banque ou un cabinet ? Demandez une démo d’Omissis.
Sources et approfondissements
Rapport Mueller
- Duff Johnson, A Technical and Cultural Assessment of the Mueller Report PDF, PDF Association, 19 avril 2019.
- Duff Johnson, The Mueller Report PDF: a content management #fail for the history books, intervention à l’Electronic Document Conference, Seattle, 18 juin 2019.
- Ernie Smith, PDF Association: Flaws in Mueller Report Show What Not to Do With a PDF, Associations Now, 23 avril 2019.
- Kevin Breuninger, Robert Mueller’s Russia probe cost nearly $32 million in total, Justice Department says, CNBC, 2 août 2019.
Affaire Manafort
- Greg Walters, Manafort shared internal polling data with alleged Russian spy during campaign, according to court filing, VICE News, 8 janvier 2019.
Affaire AstraZeneca
- Gareth Corfield, European Commission redacts AstraZeneca vaccine contract – but forgets to wipe the bookmarks tab, The Register, 29 janvier 2021.
- Nikolaj Nielsen, EU admits redaction error in AstraZeneca contract, EUobserver, 3 février 2021.
Textes
- Directive (UE) 2016/2102 relative à l’accessibilité des sites internet et des applications mobiles des organismes du secteur public.
- Directive (UE) 2019/882 relative aux exigences en matière d’accessibilité applicables aux produits et services (European Accessibility Act).