Hay un análisis que todo responsable de TI, asesor jurídico y responsable de cumplimiento debería conocer. Es el que Duff Johnson, de la PDF Association, dedicó al informe Mueller: primero en un artículo técnico y después en una ponencia en la Electronic Document Conference 2019 con un título elocuente, «The Mueller Report PDF: a content management #fail for the history books».
Johnson describe el desastre técnico que hubo detrás de la publicación de uno de los documentos judiciales más importantes de la historia reciente de Estados Unidos. Es un caso de manual de cómo no resolver la tensión entre confidencialidad y accesibilidad.
Pero no es un problema solo estadounidense. Dos años después, la Comisión Europea cometió un error igual de llamativo: distinto en la técnica, idéntico en el fondo.
Estos son los tres actos de una comedia de errores digitales, que muestra por qué el «rectángulo negro» no basta.
Acto primero: el error «Manafort» (el texto bajo el negro)
Enero de 2019. Los abogados de Paul Manafort, exjefe de campaña de Trump y figura clave de la investigación del fiscal especial Robert Mueller, presentan un escrito ante el tribunal federal.
El PDF contiene pasajes bajo secreto sobre la relación entre Manafort y Konstantin Kilimnik, un hombre que según el FBI tiene vínculos con la inteligencia rusa. Los abogados los cubrieron con rectángulos negros.
Solo había un problema: el texto de debajo seguía ahí.
Los periodistas seleccionaron las líneas «tachadas», las copiaron y las pegaron en un documento de Word, como contó VICE News. Información bajo secreto, legible en segundos: entre otras cosas, la acusación de haber compartido con Kilimnik encuestas de la campaña de 2016.
¿El error técnico? Los rectángulos negros solo estaban dibujados encima del texto. Una herramienta de anonimización de verdad elimina el contenido del archivo; aquí el texto original seguía intacto, bajo la pintura.
Lección n.º 1: tapar no es anonimizar. Es una ilusión óptica.
Acto segundo: la reacción «Mueller» (el despilfarro)
Abril de 2019. Tres meses después del bochorno de Manafort, el Departamento de Justicia (DOJ) publica el informe Mueller: 448 páginas, fruto de una investigación que costó a los contribuyentes casi 32 millones de dólares.
Esta vez no queda ningún texto oculto bajo el negro. Pero el precio es muy alto: el archivo publicado es un PDF formado solo por imágenes. Según la PDF Association, todo indica que el informe, una vez tachado, se imprimió y se pasó por un escáner.
El resultado es un PDF de 139 megabytes hecho de fotos de páginas. El análisis de la PDF Association describe un fracaso en toda regla:
- Sin búsqueda de texto: para encontrar un nombre o una fecha había que recorrer 448 páginas a mano.
- Accesibilidad cero: para los lectores de pantalla que usan las personas ciegas, el documento era una sucesión de imágenes sin texto. Para la asociación, el archivo no cumplía la Section 508, la norma federal sobre accesibilidad de los documentos públicos.
- Calidad degradada: páginas con grano y una fina línea amarilla que dejó el escáner.
- Peso inútil: un archivo mucho más pesado de lo que habría sido un PDF nativo.
Para Duff Johnson, el PDF de imágenes era, de todas las opciones posibles, «la menos fácil de usar». Pocos días después, el DOJ volvió a publicar el informe con texto seleccionable, pero los problemas de reconocimiento del texto siguieron ahí.
Lección n.º 2: consiguieron la confidencialidad destruyendo todo lo demás.
Acto tercero: el «Manafort europeo» (los marcadores olvidados)
Enero de 2021. En plena pandemia, la Comisión Europea está bajo presión para hacer públicos sus contratos de compra de vacunas contra la COVID-19. El 29 de enero publica el contrato con AstraZeneca, con muchas partes censuradas para proteger información comercial confidencial.
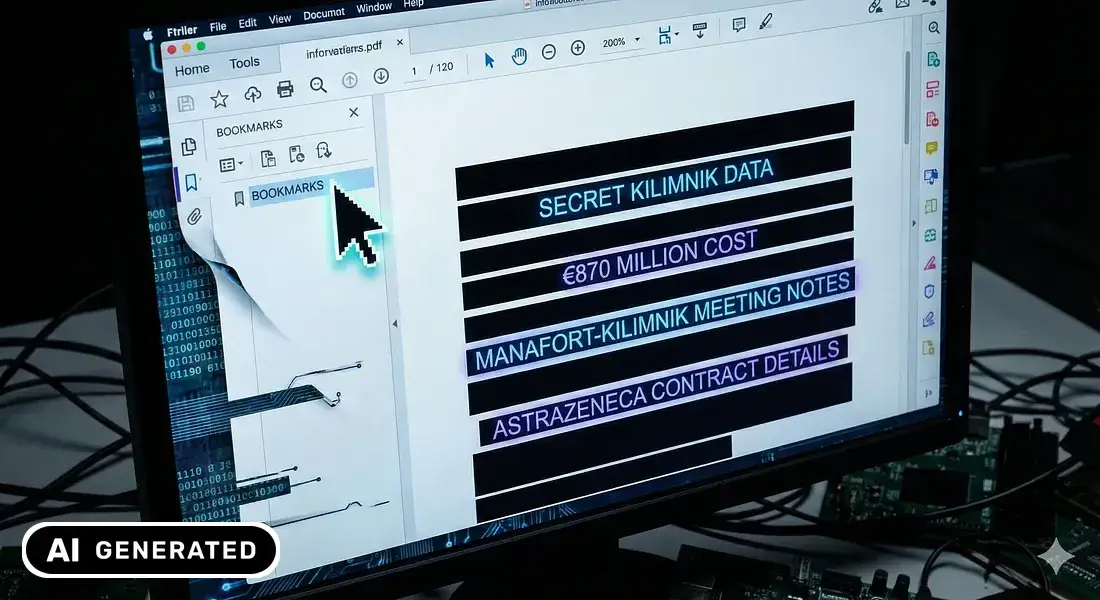
Las barras negras sobre el texto estaban todas en su sitio. Pero nadie había revisado los marcadores.
En los lectores de PDF, los marcadores son el índice de navegación del panel lateral, que a menudo se genera automáticamente a partir del texto del documento.
Qué pasó:
- El documento mostraba barras negras sobre párrafos enteros.
- Sin embargo, al abrir el panel «Marcadores», partes del texto censurado aparecían en claro.
- Entre los detalles legibles había cifras como los 870 millones de euros de costes previstos para las dosis destinadas a la Unión.
Lo detectaron usuarios en la red y periodistas de Der Spiegel; The Register lo contó ese mismo día. La Comisión sustituyó el PDF ese día y pocos días después admitió el error. Pero el daño ya estaba hecho.
Lección n.º 3: si no limpias las capas ocultas (metadatos, marcadores, estructura), tus secretos están a un clic.
Tres errores, una raíz común
La diferencia técnica entre los casos es sutil pero importante:
| Caso | Error | Consecuencia |
|---|---|---|
| Manafort | Rectángulos negros dibujados encima del texto | Texto copiable con Ctrl+C |
| AstraZeneca | Marcadores sin limpiar | Texto confidencial legible en el panel lateral |
| Mueller | PDF de solo imágenes (impresión y escaneo) | Documento pesado, sin búsqueda y no accesible |
La raíz es la misma: tratar el PDF como una hoja de papel.
Un PDF no es una fotografía. Es un contenedor por capas (como una lasaña) que incluye:
- texto seleccionable (el contenido);
- formas y anotaciones (lo que se añade encima);
- metadatos y marcadores (información y navegación);
- etiquetas de accesibilidad (la estructura).
Anonimizar de verdad un PDF significa limpiar con precisión todas estas capas.
Por qué nos afecta (sobre todo en Europa)
En Europa no podemos elegir entre privacidad y accesibilidad: con el RGPD por un lado y las normas de accesibilidad por otro, hacen falta las dos.
Para las administraciones públicas la obligación existe desde hace años: la Directiva (UE) 2016/2102 sobre la accesibilidad de los sitios web y las aplicaciones móviles de los organismos del sector público, incorporada al derecho nacional de cada Estado miembro, alcanza también a los documentos publicados en línea. Desde el 28 de junio de 2025, la European Accessibility Act (Directiva (UE) 2019/882) extiende requisitos de accesibilidad a muchos productos y servicios del sector privado, de los servicios bancarios al comercio electrónico. Un documento de solo imágenes como el primer informe Mueller difícilmente superaría el examen.
Y sin embargo, el «escaneo defensivo» sigue siendo habitual en las oficinas: se imprime, se tacha con rotulador y se escanea. El resultado es un archivo inútil para quien usa tecnologías de apoyo.
Lista de comprobación: qué hacer en la práctica
Si gestionas documentos legales o de RR. HH., estas son las reglas de oro:
- Usa una herramienta de anonimización de verdad. Tiene que eliminar el texto, no taparlo. Con el PDF Editor de Edito, gratis con una cuenta gratuita, la anonimización de los datos personales se hace en tu ordenador y es irreversible. Nunca formas ni resaltadores negros.
- Aplica y comprueba. Después de anonimizar, intenta seleccionar la zona y busca en el archivo una palabra que hayas eliminado. Si la encuentras, algo falla.
- Limpia los metadatos. Quita autor, comentarios, historial de revisiones y adjuntos que no deben salir con el documento.
- Ojo con los marcadores. Abre siempre el panel lateral antes de publicar: las entradas del índice pueden revelar lo que has borrado del texto.
- No escanees (casi nunca). El escaneo destruye la búsqueda y la accesibilidad. Si no tienes alternativa, después necesitas OCR y etiquetas de accesibilidad: Edito in cloud ofrece OCR avanzado, conversión a PDF/A y verificación de conformidad PDF/A y PDF/UA.
La moraleja
El PDF puede hacer muchísimas cosas: es su fuerza y también el origen de estos desastres. La tecnología no perdona los atajos, pero siempre ofrece una solución. Solo hace falta que no sea el escáner.
Anonimiza tus PDF sin que salgan de tu ordenador.
Descarga PDF Editor gratisSolo necesitas una cuenta gratuita.
¿Gestionas grandes volúmenes de documentos en una administración, un banco o un despacho? Solicita una demo de Omissis.
Fuentes y lecturas
Informe Mueller
- Duff Johnson, A Technical and Cultural Assessment of the Mueller Report PDF, PDF Association, 19 de abril de 2019.
- Duff Johnson, The Mueller Report PDF: a content management #fail for the history books, ponencia en la Electronic Document Conference, Seattle, 18 de junio de 2019.
- Ernie Smith, PDF Association: Flaws in Mueller Report Show What Not to Do With a PDF, Associations Now, 23 de abril de 2019.
- Kevin Breuninger, Robert Mueller’s Russia probe cost nearly $32 million in total, Justice Department says, CNBC, 2 de agosto de 2019.
Caso Manafort
- Greg Walters, Manafort shared internal polling data with alleged Russian spy during campaign, according to court filing, VICE News, 8 de enero de 2019.
Caso AstraZeneca
- Gareth Corfield, European Commission redacts AstraZeneca vaccine contract – but forgets to wipe the bookmarks tab, The Register, 29 de enero de 2021.
- Nikolaj Nielsen, EU admits redaction error in AstraZeneca contract, EUobserver, 3 de febrero de 2021.
Normativa
- Directiva (UE) 2016/2102 sobre la accesibilidad de los sitios web y aplicaciones para dispositivos móviles de los organismos del sector público.
- Directiva (UE) 2019/882 sobre los requisitos de accesibilidad de los productos y servicios (European Accessibility Act).