Es gibt eine Analyse, die jeder IT-Leiter, jeder Unternehmensjurist und jeder Compliance-Verantwortliche kennen sollte. Duff Johnson von der PDF Association hat sie dem Mueller-Bericht gewidmet: zuerst in einem Fachartikel, dann in einem Vortrag auf der Electronic Document Conference 2019 mit dem vielsagenden Titel „The Mueller Report PDF: a content management #fail for the history books“.
Johnson beschreibt das technische Desaster hinter der Veröffentlichung eines der wichtigsten juristischen Dokumente der jüngeren amerikanischen Geschichte. Es ist ein Lehrbuchbeispiel dafür, wie man das Spannungsfeld zwischen Vertraulichkeit und Barrierefreiheit nicht auflöst.
Doch das ist kein rein amerikanisches Problem. Zwei Jahre später machte die Europäische Kommission einen ebenso spektakulären Fehler: technisch anders, in der Sache identisch.
Hier sind die drei Akte einer digitalen Komödie der Irrungen, die zeigt, warum der „schwarze Balken“ nicht reicht.
Erster Akt: der „Manafort“-Fehler (der Text unter dem Schwarz)
Januar 2019. Die Anwälte von Paul Manafort, Trumps früherem Wahlkampfleiter und Schlüsselfigur der Ermittlungen von Sonderermittler Robert Mueller, reichen beim Bundesgericht einen Schriftsatz ein.
Das PDF enthält unter Verschluss stehende Passagen über Manaforts Beziehungen zu Konstantin Kilimnik, einem Mann, der nach Einschätzung des FBI Verbindungen zum russischen Geheimdienst hat. Die Anwälte haben sie mit schwarzen Balken überdeckt.
Es gab nur ein Problem: Der Text darunter war noch da.
Journalisten markierten die „geschwärzten“ Zeilen, kopierten sie und fügten sie in ein Word-Dokument ein, wie VICE News berichtete. Unter Verschluss stehende Informationen, in Sekunden lesbar: darunter der Vorwurf, Manafort habe Umfragedaten aus dem Wahlkampf 2016 mit Kilimnik geteilt.
Der technische Fehler? Die schwarzen Balken waren nur über den Text gezeichnet. Ein echtes Schwärzungswerkzeug entfernt den Inhalt aus der Datei; hier war der Originaltext unversehrt geblieben, unter der Farbe.
Lektion 1: Überdecken ist nicht Schwärzen. Es ist eine optische Täuschung.
Zweiter Akt: die „Mueller“-Reaktion (die Verschwendung)
April 2019. Drei Monate nach der Manafort-Blamage veröffentlicht das Justizministerium (DOJ) den Mueller-Bericht: 448 Seiten, Ergebnis einer Untersuchung, die die Steuerzahler fast 32 Millionen Dollar gekostet hat.
Diesmal bleibt kein Text unter dem Schwarz verborgen. Doch der Preis ist hoch: Die veröffentlichte Datei ist ein reines Bild-PDF. Nach Einschätzung der PDF Association deutet alles darauf hin, dass der Bericht nach der Schwärzung ausgedruckt und durch einen Scanner geschickt wurde.
Das Ergebnis ist ein 139 Megabyte großes PDF aus Fotos von Seiten. Die Analyse der PDF Association beschreibt ein Versagen auf ganzer Linie:
- Keine Textsuche: Um einen Namen oder ein Datum zu finden, musste man 448 Seiten von Hand durchblättern.
- Null Barrierefreiheit: Für die Screenreader blinder Menschen war das Dokument eine Abfolge von Bildern ohne Text. Aus Sicht des Verbands erfüllte die Datei Section 508 nicht, die Bundesvorschrift zur Barrierefreiheit öffentlicher Dokumente.
- Schlechtere Qualität: körnige Seiten und eine dünne gelbe Linie, die der Scanner hinterlassen hat.
- Unnötiges Gewicht: eine Datei, die weit größer ist, als es ein natives PDF gewesen wäre.
Für Duff Johnson war das Bild-PDF von allen möglichen Optionen die „am wenigsten benutzerfreundliche“. Wenige Tage später stellte das DOJ den Bericht mit auswählbarem Text neu ein, doch die Probleme bei der Texterkennung blieben.
Lektion 2: Sie haben Vertraulichkeit erreicht, indem sie alles andere zerstört haben.
Dritter Akt: der „europäische Manafort“ (die vergessenen Lesezeichen)
Januar 2021. Mitten in der Pandemie steht die Europäische Kommission unter Druck, ihre Kaufverträge für COVID-19-Impfstoffe offenzulegen. Am 29. Januar veröffentlicht sie den Vertrag mit AstraZeneca, in dem viele Teile geschwärzt sind, um vertrauliche Geschäftsinformationen zu schützen.
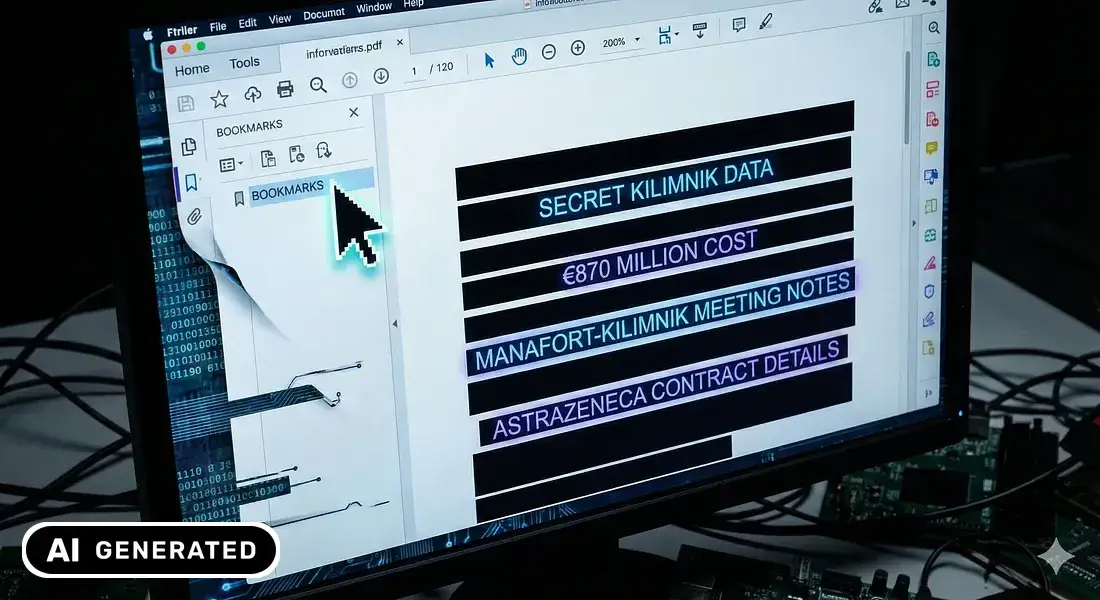
Die schwarzen Balken über dem Text waren alle an ihrem Platz. Doch niemand hatte die Lesezeichen geprüft.
In PDF-Readern sind Lesezeichen das Navigationsverzeichnis in der Seitenleiste, das oft automatisch aus dem Text des Dokuments erzeugt wird.
Was passiert ist:
- Das Dokument zeigte schwarze Balken über ganzen Absätzen.
- Öffnete man jedoch den Bereich „Lesezeichen“, erschienen Teile des geschwärzten Textes im Klartext.
- Zu den lesbaren Details gehörten Zahlen wie die 870 Millionen Euro an erwarteten Kosten für die Dosen, die für die Union bestimmt waren.
Bemerkt haben es Nutzer im Netz und Journalisten des Spiegel; The Register berichtete noch am selben Tag. Die Kommission tauschte das PDF am selben Tag aus und räumte den Fehler wenige Tage später ein. Doch da war der Schaden schon da.
Lektion 3: Wenn Sie die verborgenen Ebenen (Metadaten, Lesezeichen, Struktur) nicht bereinigen, sind Ihre Geheimnisse nur einen Klick entfernt.
Drei Fehler, eine gemeinsame Wurzel
Der technische Unterschied zwischen den Fällen ist fein, aber wichtig:
| Fall | Fehler | Folge |
|---|---|---|
| Manafort | Schwarze Balken über den Text gezeichnet | Text mit Strg+C kopierbar |
| AstraZeneca | Lesezeichen nicht bereinigt | Vertraulicher Text in der Seitenleiste lesbar |
| Mueller | Reines Bild-PDF (Druck und Scan) | Schweres, nicht durchsuchbares, nicht barrierefreies Dokument |
Die Wurzel ist dieselbe: das PDF wie ein Blatt Papier zu behandeln.
Ein PDF ist kein Foto. Es ist ein Container aus Schichten (wie eine Lasagne) mit:
- auswählbarem Text (dem Inhalt);
- Formen und Anmerkungen (dem, was darübergelegt wird);
- Metadaten und Lesezeichen (Informationen und Navigation);
- Tags für die Barrierefreiheit (der Struktur).
Ein PDF wirklich zu schwärzen heißt, all diese Ebenen sorgfältig zu bereinigen.
Warum uns das betrifft (besonders in Europa)
In Europa können wir nicht zwischen Datenschutz und Barrierefreiheit wählen: mit der DSGVO auf der einen und den Regeln zur Barrierefreiheit auf der anderen Seite brauchen wir beides.
Für öffentliche Stellen besteht die Pflicht seit Jahren: Die Richtlinie (EU) 2016/2102 über den barrierefreien Zugang zu den Websites und mobilen Anwendungen öffentlicher Stellen, in jedem Mitgliedstaat in nationales Recht umgesetzt, gilt auch für online veröffentlichte Dokumente. Seit dem 28. Juni 2025 dehnt der European Accessibility Act (Richtlinie (EU) 2019/882) Anforderungen an die Barrierefreiheit auf viele Produkte und Dienstleistungen der Privatwirtschaft aus, von Bankdienstleistungen bis zum Onlinehandel. Ein reines Bild-Dokument wie der erste Mueller-Bericht würde die Prüfung kaum bestehen.
Und doch ist das „defensive Scannen“ in Büros noch verbreitet: ausdrucken, mit dem Filzstift schwärzen, einscannen. Das Ergebnis ist eine Datei, die für Menschen mit assistiven Technologien nutzlos ist.
Checkliste: Was in der Praxis zu tun ist
Wenn Sie juristische oder HR-Dokumente verwalten, sind das die goldenen Regeln:
- Verwenden Sie ein echtes Schwärzungswerkzeug. Es muss den Text entfernen, nicht überdecken. Mit dem PDF Editor von Edito, kostenlos mit einem kostenlosen Konto, werden personenbezogene Daten auf Ihrem eigenen Computer geschwärzt, und die Schwärzung ist unumkehrbar. Niemals Formen oder schwarze Textmarker.
- Anwenden und prüfen. Versuchen Sie nach dem Schwärzen, den Bereich zu markieren und in der Datei nach einem entfernten Wort zu suchen. Wenn Sie es finden, stimmt etwas nicht.
- Bereinigen Sie die Metadaten. Entfernen Sie Autor, Kommentare, Änderungsverlauf und Anhänge, die das Dokument nicht begleiten dürfen.
- Achten Sie auf die Lesezeichen. Öffnen Sie vor der Veröffentlichung immer die Seitenleiste: Die Einträge des Verzeichnisses können verraten, was Sie im Text gelöscht haben.
- Scannen Sie nicht (fast nie). Scannen zerstört Suche und Barrierefreiheit. Wenn es nicht anders geht, brauchen Sie danach OCR und Tags für die Barrierefreiheit: Edito in cloud bietet erweiterte OCR, die Konvertierung in PDF/A und die Konformitätsprüfung für PDF/A und PDF/UA.
Die Moral
PDF kann sehr viel: Das ist seine Stärke und zugleich der Ursprung dieser Desaster. Technologie verzeiht keine Abkürzungen, bietet aber immer eine Lösung. Es sollte nur nicht der Scanner sein.
Schwärzen Sie Ihre PDFs, ohne dass sie Ihren Computer verlassen.
PDF Editor kostenlos herunterladenSie brauchen nur ein kostenloses Konto.
Verwalten Sie große Dokumentenmengen in einer Behörde, einer Bank oder einer Kanzlei? Fordern Sie eine Demo von Omissis an.
Quellen und weiterführende Texte
Mueller-Bericht
- Duff Johnson, A Technical and Cultural Assessment of the Mueller Report PDF, PDF Association, 19. April 2019.
- Duff Johnson, The Mueller Report PDF: a content management #fail for the history books, Vortrag auf der Electronic Document Conference, Seattle, 18. Juni 2019.
- Ernie Smith, PDF Association: Flaws in Mueller Report Show What Not to Do With a PDF, Associations Now, 23. April 2019.
- Kevin Breuninger, Robert Mueller’s Russia probe cost nearly $32 million in total, Justice Department says, CNBC, 2. August 2019.
Fall Manafort
- Greg Walters, Manafort shared internal polling data with alleged Russian spy during campaign, according to court filing, VICE News, 8. Januar 2019.
Fall AstraZeneca
- Gareth Corfield, European Commission redacts AstraZeneca vaccine contract – but forgets to wipe the bookmarks tab, The Register, 29. Januar 2021.
- Nikolaj Nielsen, EU admits redaction error in AstraZeneca contract, EUobserver, 3. Februar 2021.
Rechtsakte
- Richtlinie (EU) 2016/2102 über den barrierefreien Zugang zu den Websites und mobilen Anwendungen öffentlicher Stellen.
- Richtlinie (EU) 2019/882 über die Barrierefreiheitsanforderungen für Produkte und Dienstleistungen (European Accessibility Act).